
支持的模型
Weaver 支持的模型由部署配置决定。请在运行时查询 Console 或 SDK,不要依赖静态模型名单。
查找可用模型
Console 的 支持的模型 页面展示当前组织可以使用的模型,包括可用状态、上下文信息,以及训练、输入、缓存输入和输出 token 的价格。
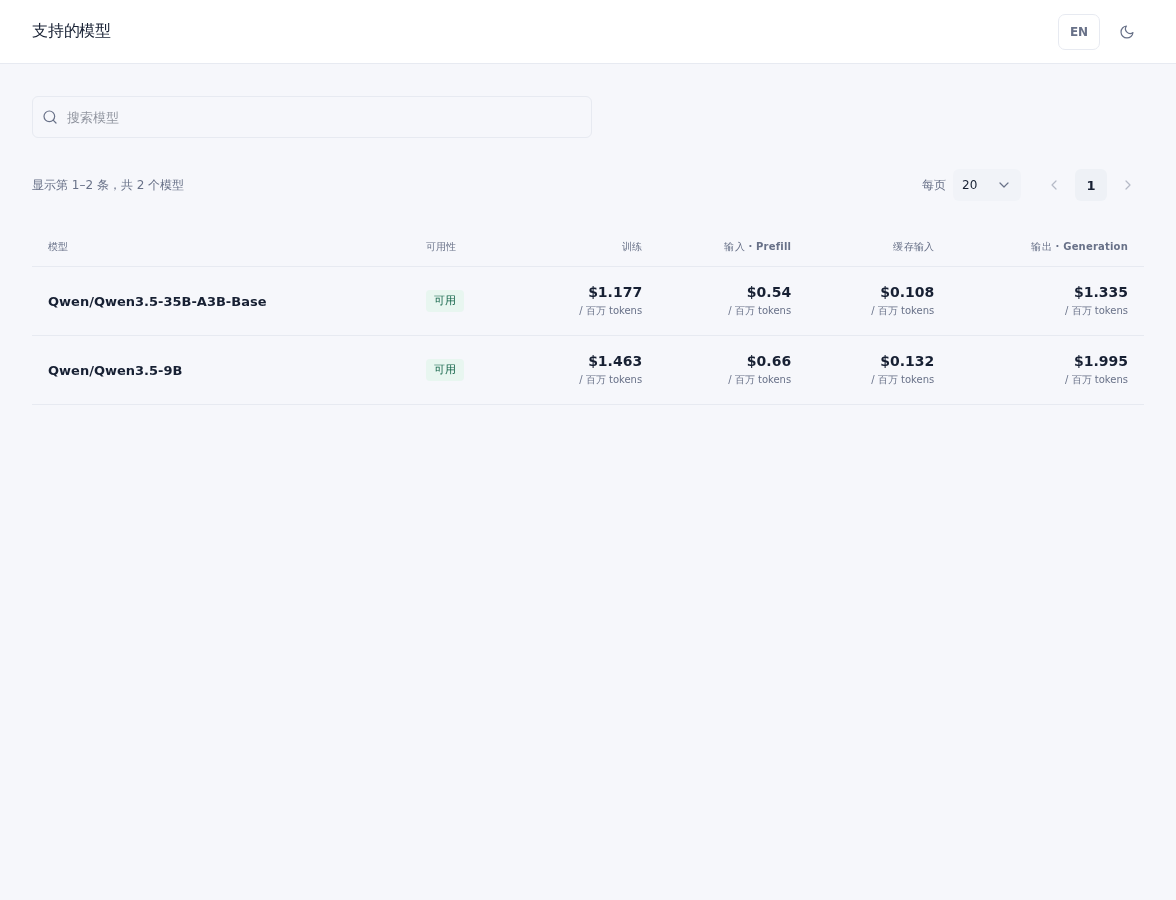
开始训练前,可以复制模型名称并比较不同类型 token 的价格。
SDK 使用相同的可见性和可用性规则:
python
from weaver import ServiceClient

with ServiceClient(organization="research") as client:
    models = client.list_supported_models()
config = client.get_supported_model_config(models[0]) if models else Nonelist_supported_models() 返回当前可用的模型名称;get_supported_model_config() 返回选择该模型所需的信息。
注意
请使用“支持的模型”页面或 SDK 返回的完整名称。不同组织和环境中可用的模型可能不同。
训练模式
LoRA
LoRA 是默认模式,通常最适合快速实验和频繁更新:
python
training_client = service_client.create_model(
    base_model="<model-from-catalog>",
    training_mode="lora",
    lora_config=types.LoraConfig(
        rank=32,
        train_attn=True,
        train_mlp=True,
        train_unembed=True,
    ),
)Full Fine-Tuning
当 LoRA 容量不足,且所选模型支持全参数训练时使用:
python
training_client = service_client.create_model(
    base_model="<model-from-catalog>",
    training_mode="full_ft",
)上下文长度
上下文长度属于模型标识。一些部署使用 :<max_seq_len> 后缀表示长上下文变体,另一些会直接写在基座模型名称中。不要自行拼接后缀,应复制页面或 SDK 返回的完整值。
当训练或采样请求的有效 token 长度超过模型配置的 max_seq_len 时,Weaver 会拒绝请求。设置采样上限时还要为生成 token 预留空间。
性能档位
performance_tier 独立于模型名称,用于选择吞吐和价格档位:
python
training_client = service_client.create_model(
    base_model="<model-from-catalog>",
    performance_tier="fast",
)常见值为 normal、fast 和 flash,具体可用性取决于模型和部署。更高档位通常以更高成本提供更高吞吐。
选型建议
- 验证数据和 loss mask 时,先选择 featured、available 的较小模型和默认 LoRA。
- 采样占比较高时,先检查四类 token 价格;output 与 prefill 分别计费。
- 只有实验确实需要时,再选择 full fine-tuning、长上下文或更高性能档位。