
核心概念
第一次使用 Weaver,只需要先记住两件事:
- 训练会话用来归纳一次实验;
- 项目决定这次实验归谁管理、费用记到哪里,以及谁能查看。
训练会话是什么?
训练会话(Session)可以理解为一次实验的文件夹。
你开始运行一段 Weaver 训练代码时,Weaver 会自动创建一个训练会话,把这次运行产生的模型、训练指标、采样活动、检查点和用量放在一起。以后打开 Console,就能按训练会话找到和比较这次实验。
例如,你运行一个名为“数学 RL 基线”的脚本。脚本中训练了两个模型,并记录 reward 和准确率。这些内容可以放在同一个训练会话里,因为它们属于同一次实验。
训练会话不是 GPU,也不是单次 API 请求。代码运行结束后,训练会话仍会保留在 Console 中。
什么时候新建,什么时候复用?
- 开始一个新的实验:让
ServiceClient创建新的训练会话; - 继续同一个实验:把已有的
session_id传给ServiceClient; - 需要查找和比较实验:创建时设置清晰的
name和labels。
from weaver import ServiceClient


with ServiceClient(
    name="数学 RL 基线",
    labels={"dataset": "math", "recipe": "grpo"},
) as client:
print(client.session_id)在 训练会话 页面,可以按名称或 ID 搜索、按 label 筛选,并固定最多六个训练会话比较指标。name 和 labels 只用于整理实验,不会改变训练结果。
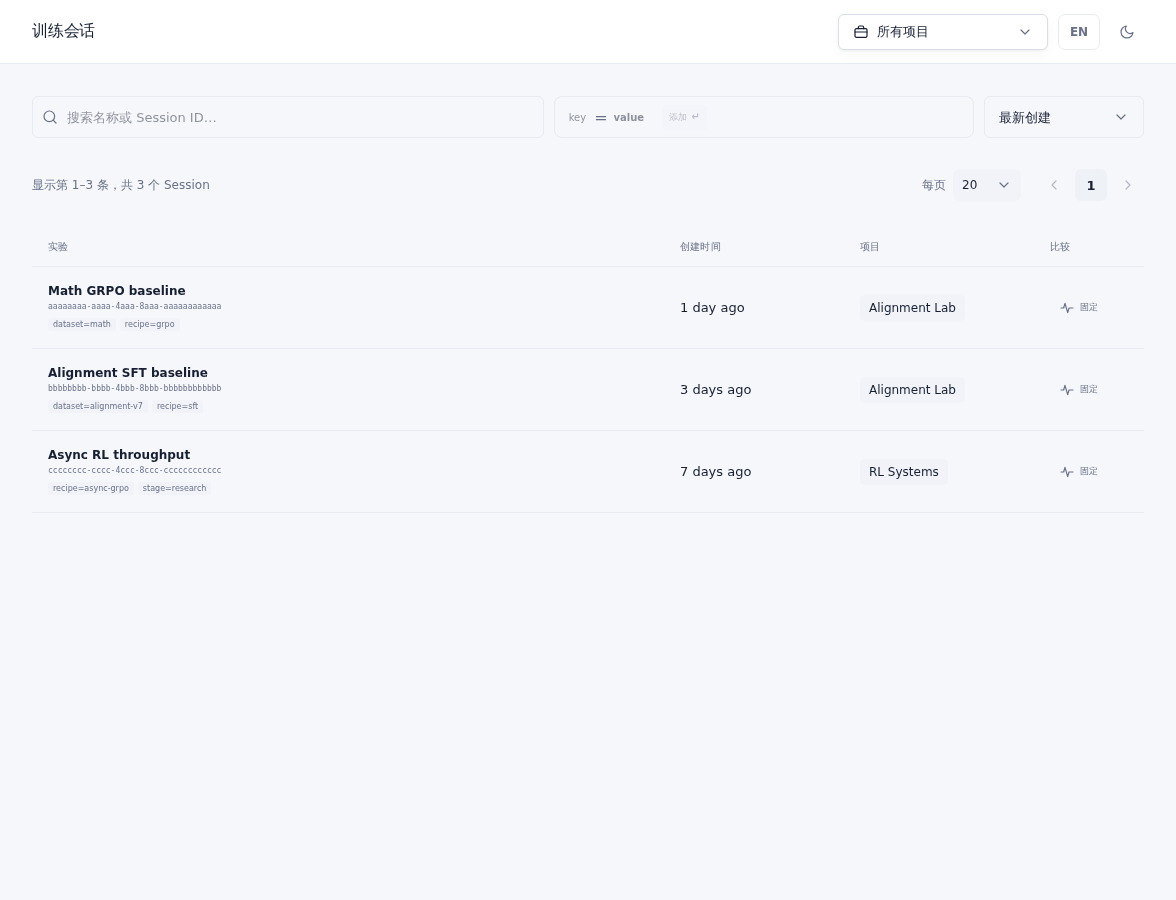
可以按名称或 ID 搜索,按 labels 和项目筛选,也可以固定训练会话比较指标。
组织、团队与项目
| 如果你想…… | 使用 | 说明 |
|---|---|---|
| 管理一个公司或研究团队的成员与额度 | 组织(Organization) | Weaver 中最大的管理和计费范围 |
| 把同一批人的项目权限放在一起管理 | 团队(Team) | 团队只负责授权,不拥有训练数据,也不单独计费 |
| 把一组相关实验放在一起,并控制谁能访问 | 项目(Project) | 训练会话和用量都会归属到项目 |
你可以从 Console 的账户菜单切换组织。在 训练会话 和 用量与计费 页面选择项目,只查看该项目的数据。
一个常见的安排是:组织对应公司,项目对应某个产品或研究方向,团队则用来批量授予项目权限。
训练运行、操作与检查点
训练运行
每调用一次 create_model(),Weaver 就会在当前训练会话中增加一条训练运行(Training Run),代表这次创建的可训练模型。
通常不需要单独管理训练运行。一个训练会话里可以有多个训练运行,例如同一个脚本同时对比两个模型。当前 Console 没有独立的“训练运行”主导航;打开训练会话后,可以进入其中的训练运行查看模型和检查点详情。
操作
前向/反向、优化器更新、权重同步和采样,都会被记录为一次操作(Operation)。正常训练时不需要逐条查看;排查失败、性能或用量问题时,这些记录才更有用。
检查点
检查点(Checkpoint)是你在某个训练阶段保存的模型状态。 它常用于:
- 训练中断后继续;
- 保留一个效果较好的版本;
- 保存 optimizer 状态,以便完整恢复训练。
检查点会一直保留到你删除它,或设置的 TTL 到期。它不同于主要用于短期评估和 RL rollout 的 sampler 权重。
其他界面术语
| 术语 | 用户需要知道什么 |
|---|---|
| 支持的模型(Supported Models) | 当前可以用于训练的基座模型,以及上下文长度和公开价格 |
| 用量(Usage) | 训练和采样实际消耗的 token,记录到组织和项目 |
| 额度(Quota) | 当前用户在某个组织内可使用的余额 |
| API 密钥(API Key) | 代表你调用 Weaver 的凭证,权限与当前账号一致 |
一次典型流程
- 选择组织和项目。
- 运行训练代码,Weaver 自动创建训练会话。
- 调用
create_model()创建要训练的模型。 - 训练、采样并记录指标。
- 在需要恢复或保留版本时保存检查点。
- 回到 Console,按训练会话查看实验结果和用量。